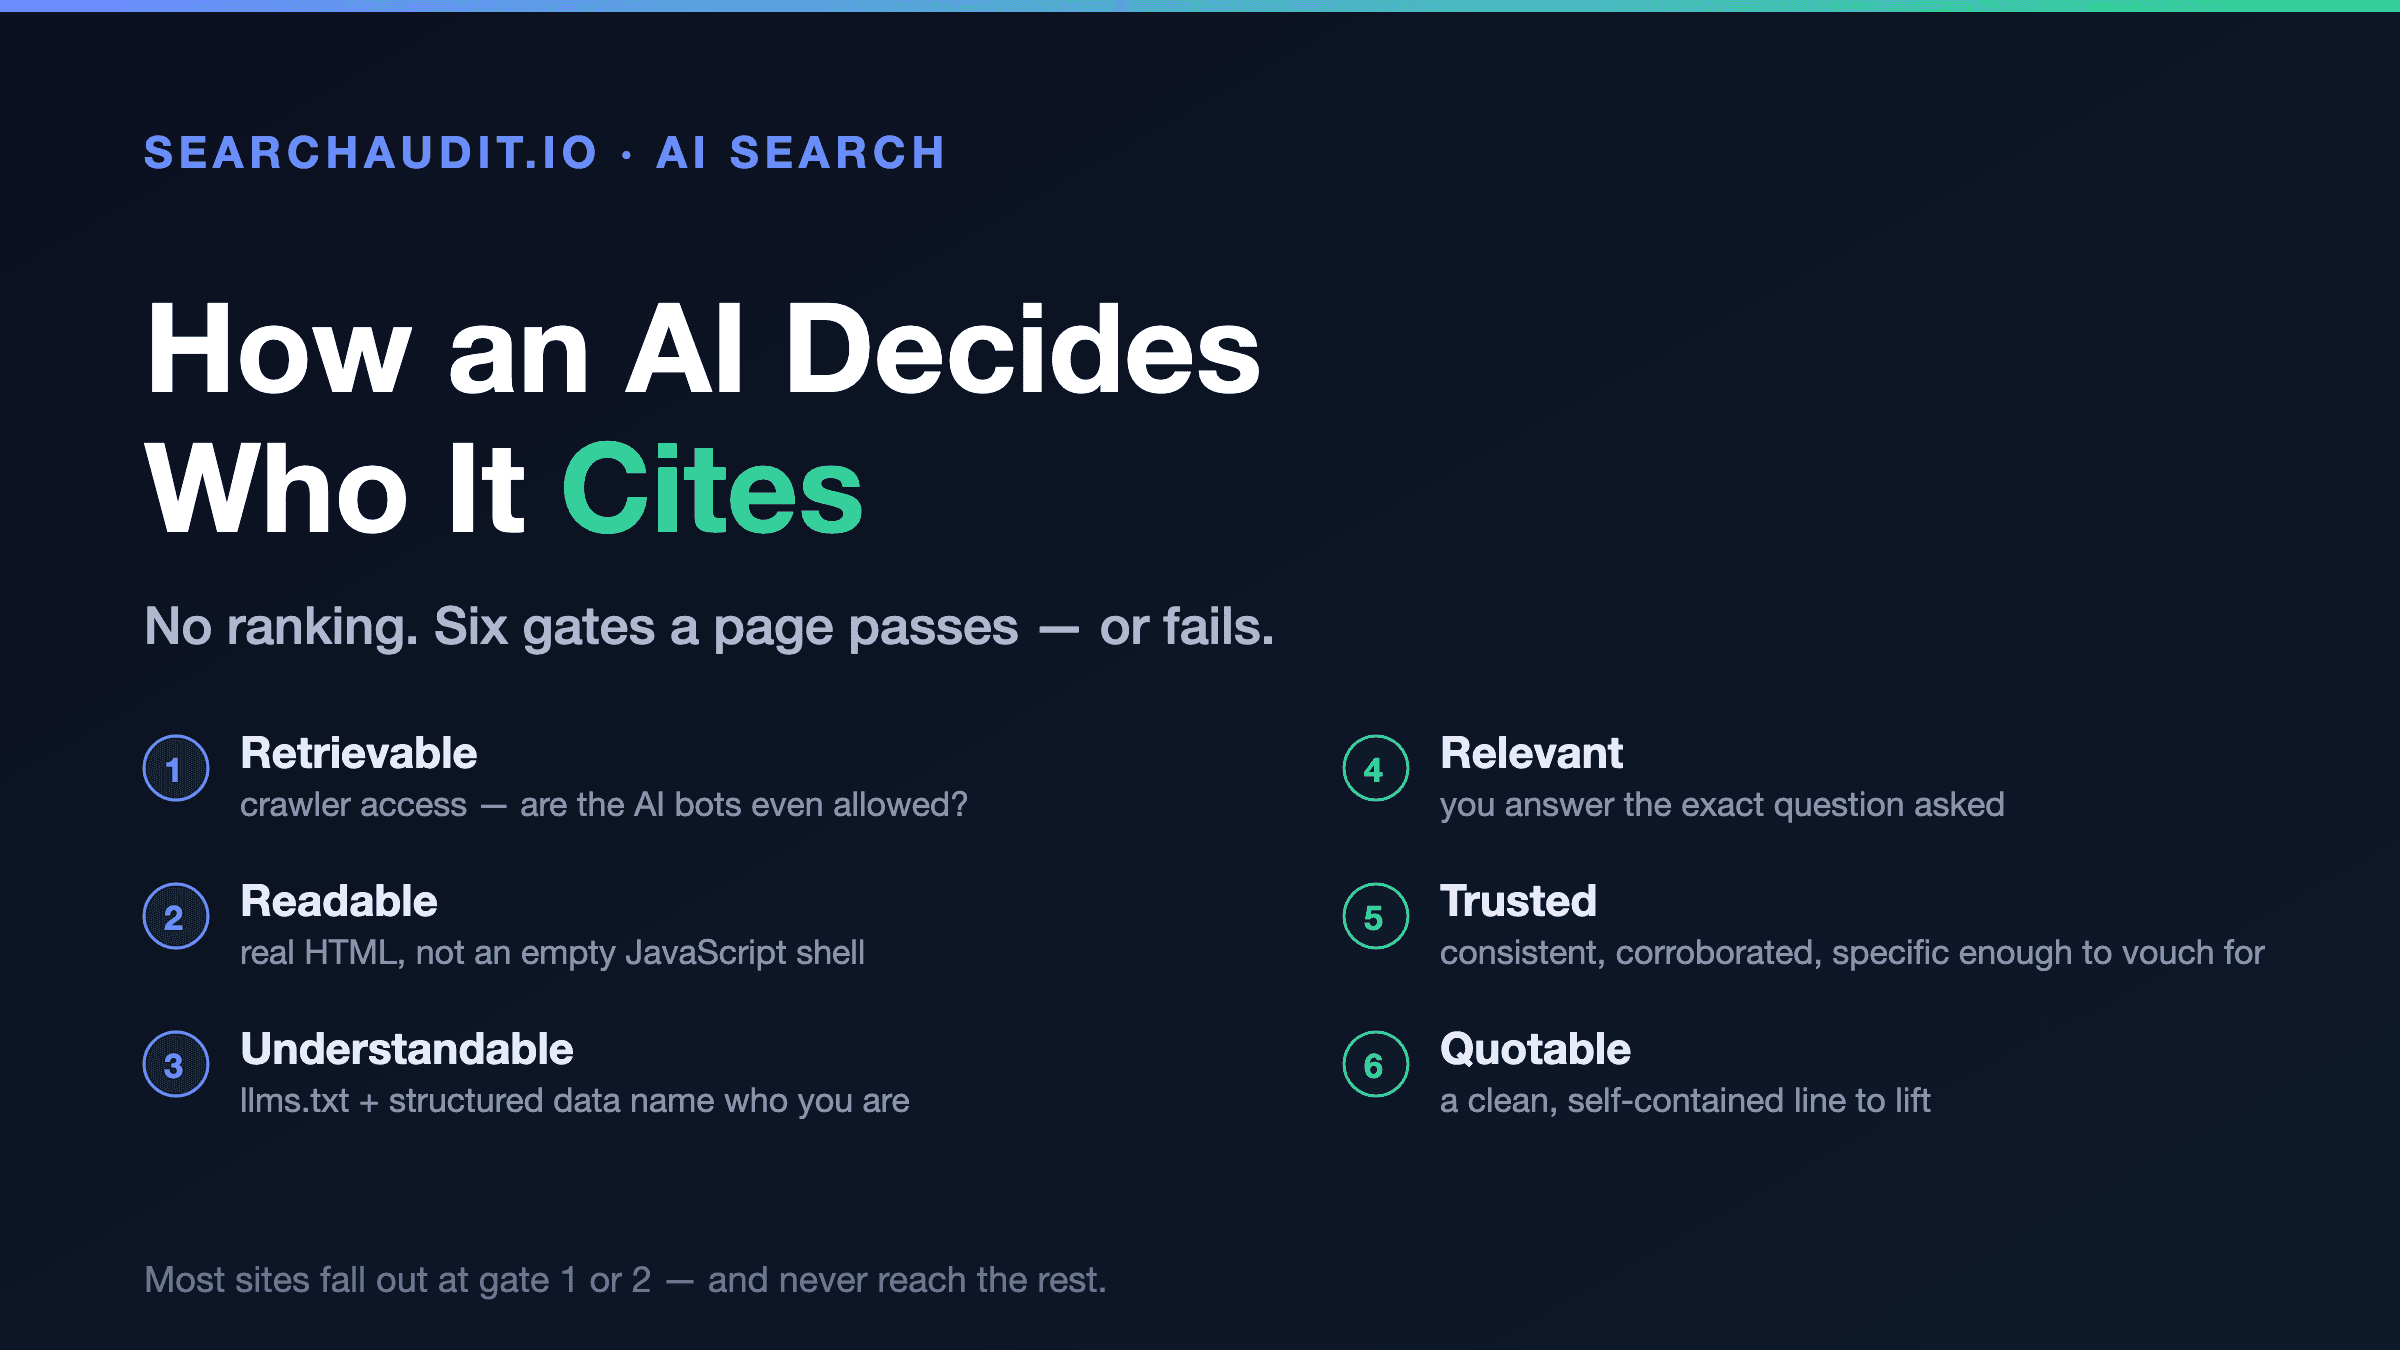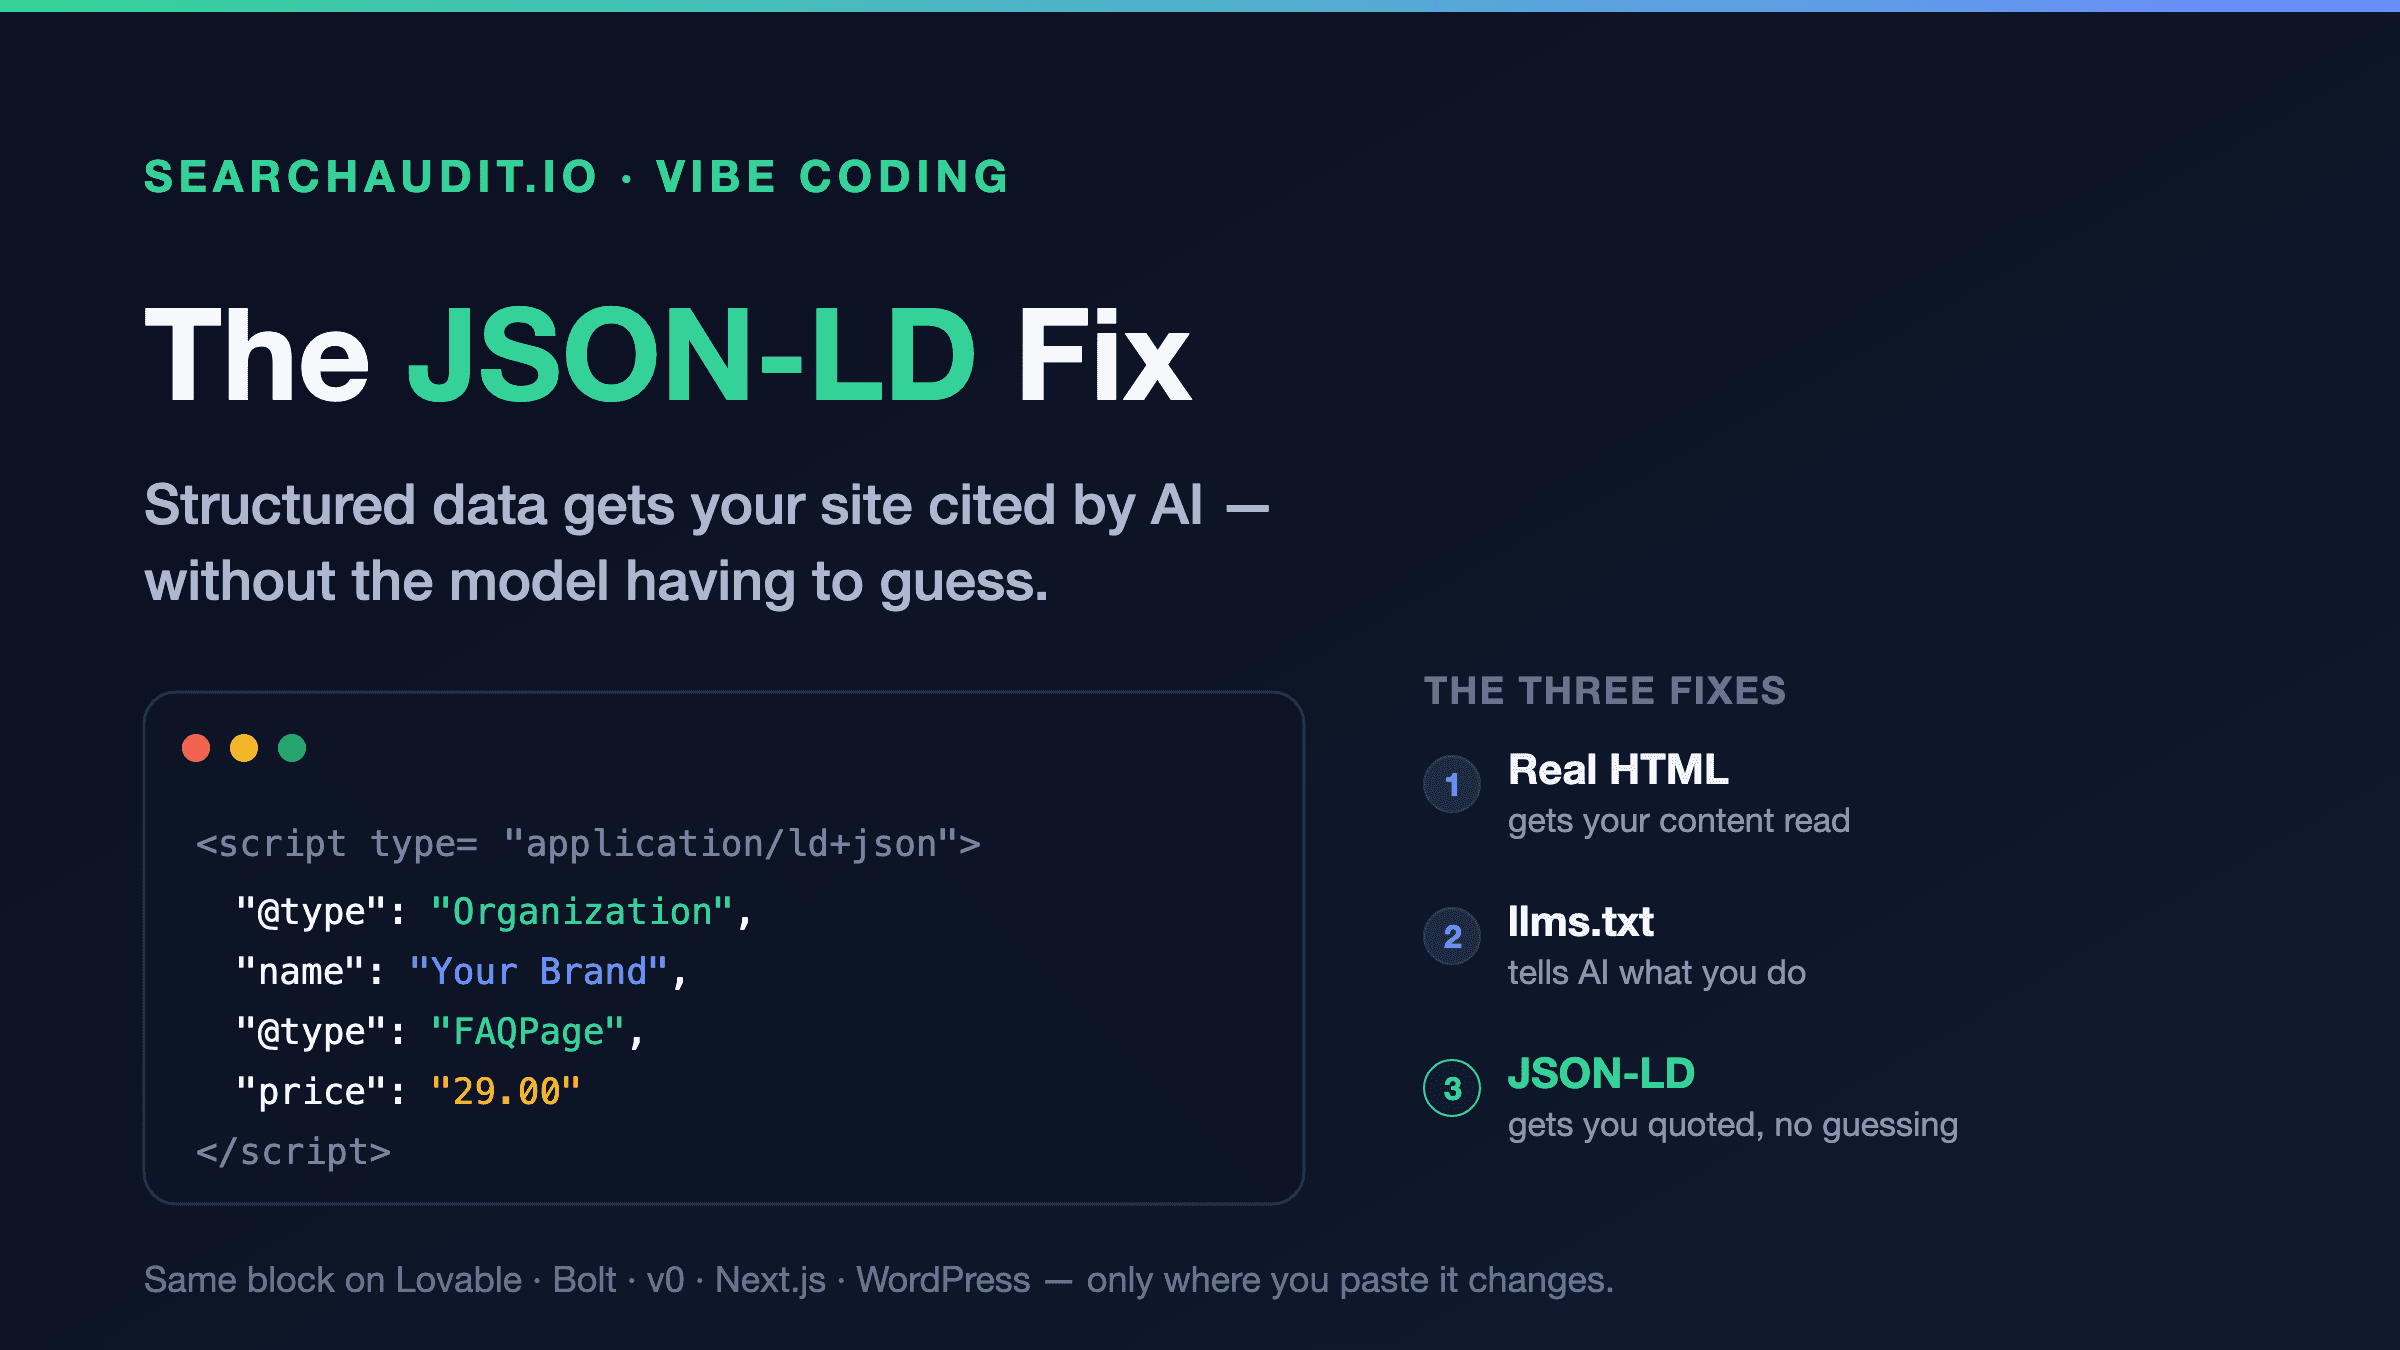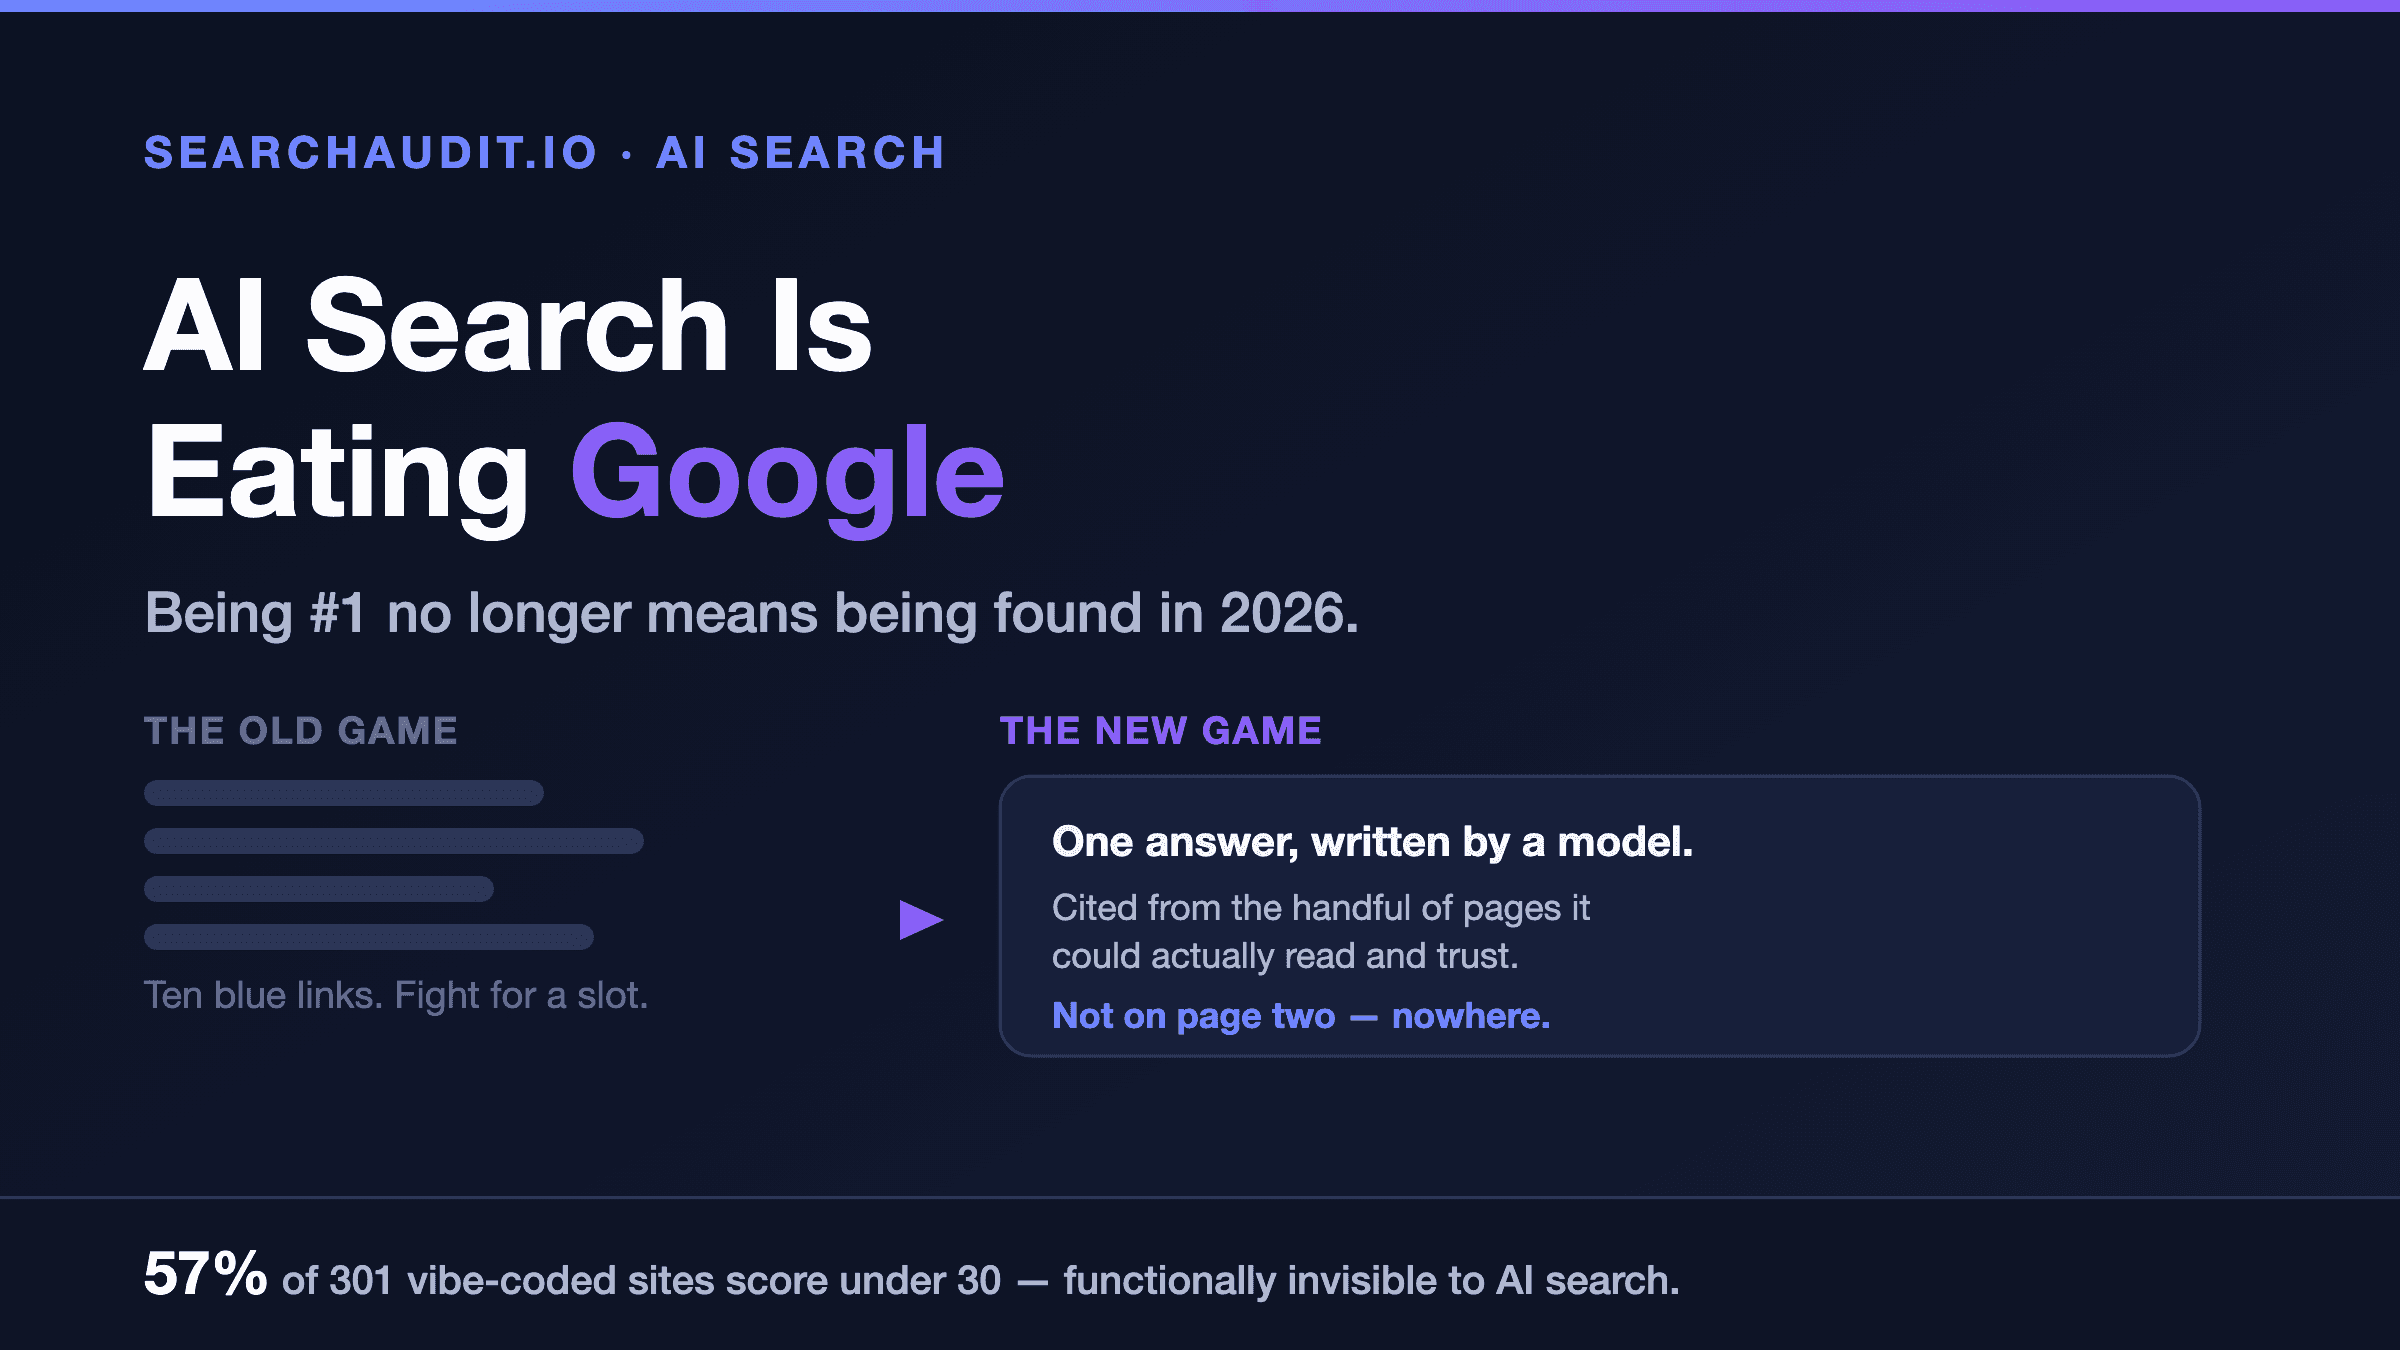
Vous pouvez avoir tout réglé par ailleurs — du vrai HTML, un llms.txt, des données structurées propres — et rester invisible pour la recherche IA pour une raison bête : votre site dit aux robots d'exploration des IA de passer leur chemin, et vous n'avez jamais su que vous l'aviez configuré ainsi.
Cela arrive plus souvent qu'on ne le croit. L'instruction se loge dans des fichiers que presque personne n'ouvre — robots.txt, une balise meta, un réglage de sécurité chez votre hébergeur — et elle est souvent activée par une valeur par défaut, un template copié ou une extension installée pour tout autre chose. Le robot se présente, lit « accès refusé », et repart. Tout ce que vous avez fait sur votre contenu devient sans objet, puisque rien n'a été lu.
Les robots qui comptent
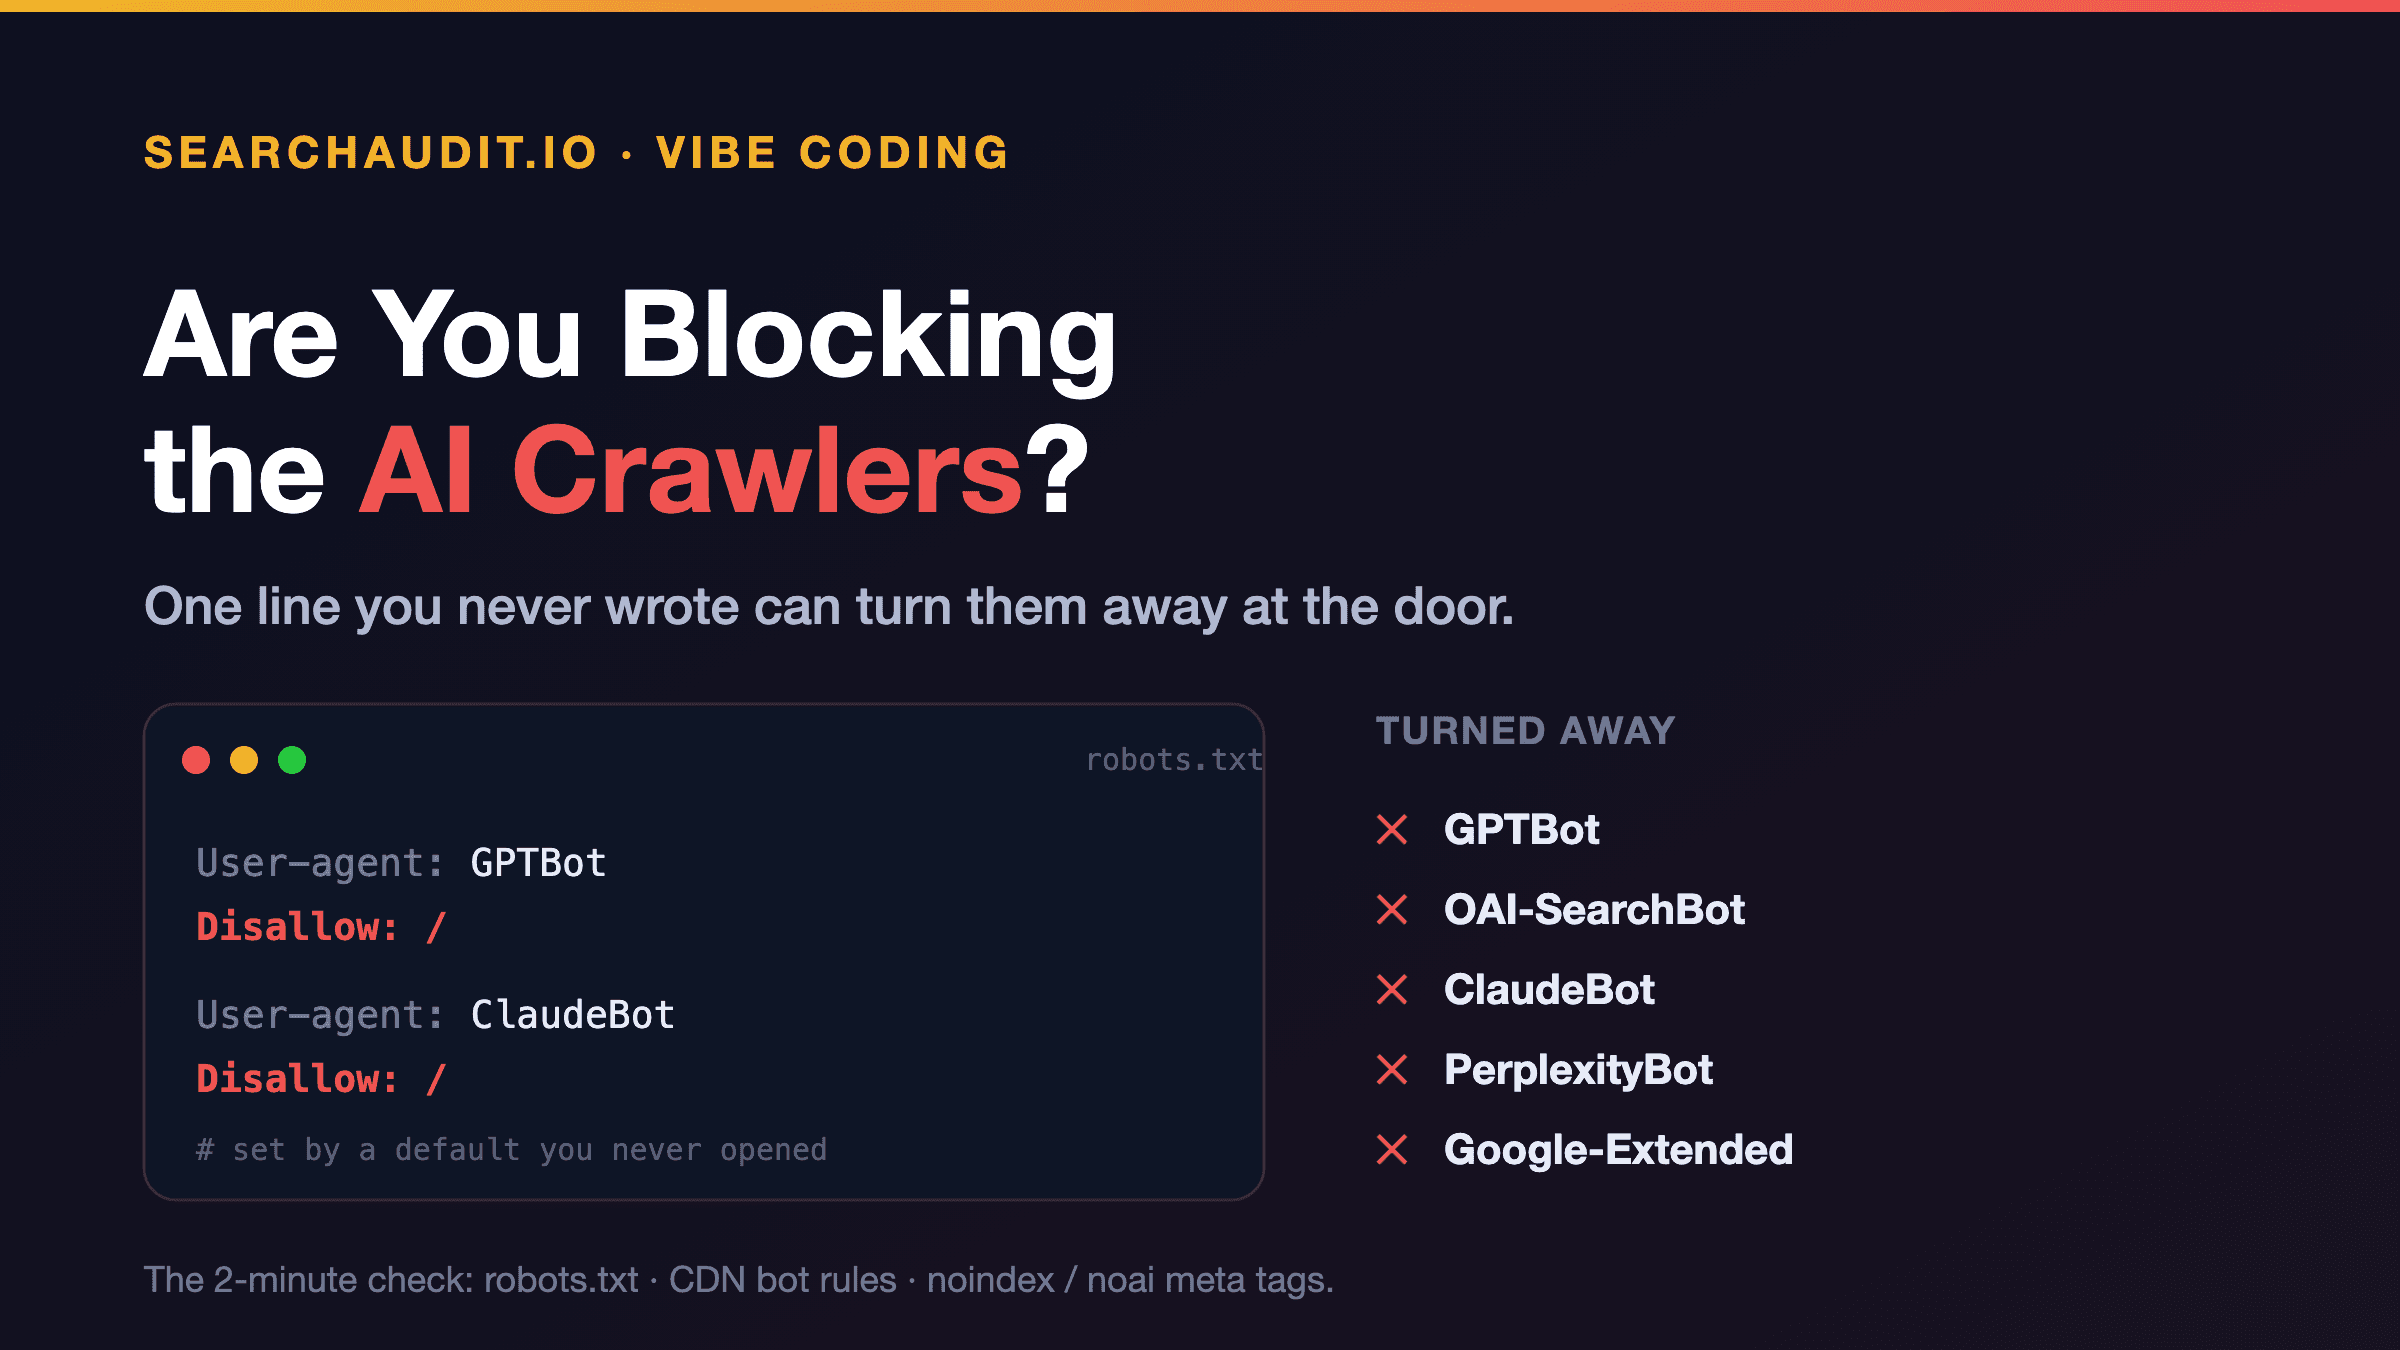
Les moteurs de recherche IA n'utilisent pas tous le même robot. Les principaux, par entreprise :
OpenAI (ChatGPT) : GPTBot, OAI-SearchBot et ChatGPT-User. Anthropic (Claude) : ClaudeBot et Claude-User. Perplexity : PerplexityBot et Perplexity-User. Google : Google-Extended — celui-ci est un interrupteur qui détermine si votre contenu peut alimenter Gemini et les réponses IA, indépendamment de l'indexation Google classique.
Les éditeurs en ajoutent et en renomment au fil du temps : considérez cette liste comme une sélection, pas comme un inventaire complet. L'essentiel est ceci : « je ne bloque pas Googlebot » ne signifie pas que vous ne bloquez pas ceux-là.
Pourquoi vous les bloquez peut-être sans le savoir
Quelques causes accidentelles fréquentes :
Une valeur par défaut de votre éditeur ou de votre template. Certains kits de démarrage livrent un robots.txt très restrictif, ou une case « décourager les moteurs de recherche » déjà cochée. Une extension de confidentialité ou de « blocage des IA ». Elles sont populaires, et beaucoup activent par défaut le blocage de GPTBot/ClaudeBot/CCBot. Parfait si c'est ce que vous voulez — problématique si vous ignoriez que cela vous retire aussi des réponses IA. Un CDN ou une couche de sécurité. Les modes anti-bots et les règles de pare-feu peuvent défier ou renvoyer un 403 à ces robots avant même qu'ils n'atteignent votre page, alors que votre robots.txt semble irréprochable. Une balise meta oubliée. Un noindex, ou une balise spécifique aux IA comme noai / noimageai, fait le même travail en silence.
Comment vérifier, en deux minutes
Ouvrez https://votresite.com/robots.txt dans un navigateur. Cherchez un Disallow: / sous User-agent: *, ou des blocages ciblés du type User-agent: GPTBot → Disallow: /. Si les robots IA sont nommés avec un disallow, vous avez votre réponse. Vérifiez chez votre hébergeur ou votre CDN les réglages « protection contre les bots », « blocage des robots IA » ou équivalent, ainsi que toute règle de pare-feu filtrant par user-agent. Affichez le code source de votre page (le HTML brut, pas la page rendue) et cherchez les balises meta robots contenant noindex, noai ou none. Inspectez les réglages de vos extensions SEO ou de confidentialité, à la recherche d'une section dédiée aux robots IA.
Comment corriger
Si vous voulez être présent dans les réponses IA, assurez-vous que rien ne bloque les robots de récupération. Dans robots.txt, cela signifie généralement supprimer un Disallow: / global et ne pas nommer les robots IA sous un disallow — ou les autoriser explicitement :
User-agent: GPTBot
Allow: /
User-agent: ClaudeBot
Allow: /
User-agent: PerplexityBot
Allow: /
Vérifiez ensuite que votre CDN ou votre pare-feu ne passe pas outre, et retirez les balises noindex/noai des pages que vous souhaitez voir citées.
La nuance honnête : bloquer les robots IA est un choix légitime. Certains ne veulent pas que leur contenu serve à entraîner des modèles, et c'est parfaitement défendable. Mais c'est une décision à prendre délibérément — pas à découvrir par hasard après s'être demandé pourquoi on n'apparaît jamais. Et la distinction mérite d'être connue : certains contrôles (comme Google-Extended) concernent l'entraînement et l'ancrage, tandis que les robots de récupération sont ceux qui vont réellement vous chercher pour vous citer dans une réponse en direct. Si l'objectif est la citation, ceux-là doivent passer.
Le moyen le plus rapide d'en avoir le cœur net. Notre audit gratuit vérifie si les robots IA peuvent réellement atteindre et lire votre site — l'accès est inclus, pas seulement le contenu. Collez votre URL, obtenez votre Score de Visibilité IA et les problèmes précis, en 60 secondes environ, sans inscription. Si l'accès est en cause, vous le verrez. Pour faire appliquer les correctifs, le Fix Pass à 29 $ (paiement unique) débloque tous les correctifs de ce site — un re-prompt, un patch de code ou une PR GitHub — sans abonnement.
Tout le reste, en visibilité IA, consiste à être lisible. Celui-ci est plus simple : commencez par vérifier que vous ne claquez pas la porte. Deux minutes dans un fichier que vous n'avez probablement jamais ouvert.
(Les noms des user-agents sont à jour à la date de publication et évoluent — vérifiez les plus récents avant toute modification. Les chiffres renvoient à l'étude SearchAudit sur 301 sites. Il s'agit de présence et de citation dans les réponses IA, pas de trafic ni de classement Google.)